Candidate 评测与晋级
冻结身份,运行可比回归,并得到确定性晋级建议。
Candidate evaluation 比 Historical 诊断回答的问题更窄:在可比评测条件下,单个受控改动是否改善了固定业务任务?
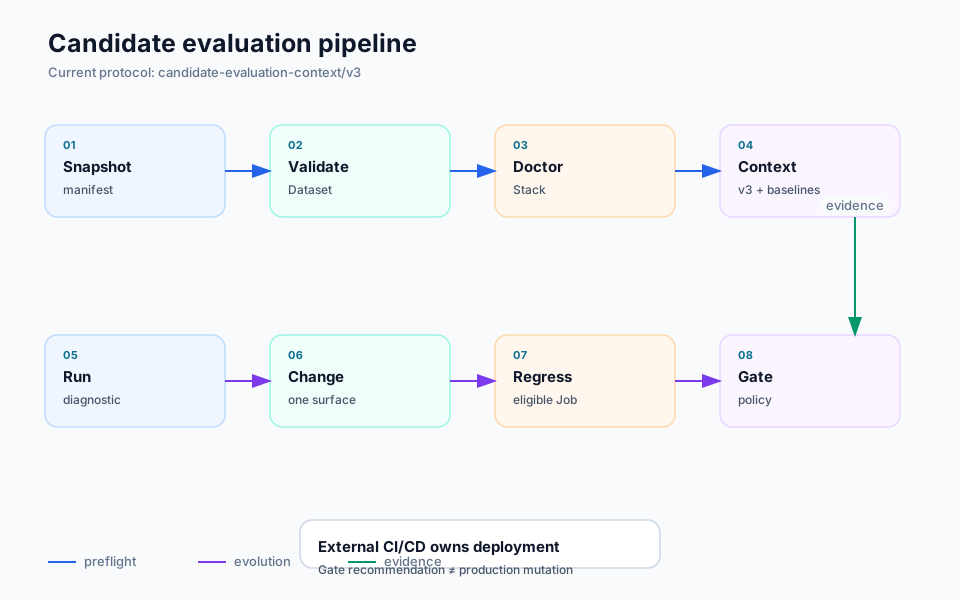
严格顺序
- 把 Candidate snapshot 为不可变 manifest。
- 验证 Dataset 身份、Task 唯一性、路径、敏感 metadata 与 source digest。
- 对 Candidate、Dataset、Evaluation Stack 和可选 Promotion Policy 运行 Doctor。
- 在昂贵 Job 前预览 Context v3 并发现可比 baseline。
- 新 Stack 或 provider 路径先跑 diagnostic。
- 只改变一个受控面:Agent 或 Evaluator,不能静默同时修改。
- 使用固定身份运行 promotion-eligible regression。
- 检查 progress、Trial output、criterion evidence 与 governance impact。
- 与可比 baseline Compare + Gate。
可比性
只使用同一个仓库,不代表 baseline 可比。Candidate manifest、Dataset manifest、Evaluation Stack、Context、执行环境以及相关 model/Judge 身份必须满足契约。Dataset digest、Stack 版本、provider 身份或 runtime 边界变化都可能要求新 baseline。
Gate
对固定 baseline Job、Candidate Job 与 policy 输入,Gate 是确定性的。它根据 valid score 变化、最小改进、回归、coverage 等 policy 条件返回 PROMOTE 或 REJECT。
它不会部署、修改 Champion 或绕过外部 CI/CD 批准。
0.9.7 已在 Dashboard overview 与 Job detail 中接受 Candidate Context v3。Compare/Gate 仍由 Artifact 有效性、身份可比性、mode 与 policy 控制。
发布测试不能证明什么
0.9.7 未运行真实供应商模型、真实 Candidate/Historical Session 数据或付费 Harbor 评测;自动化测试结论不构成业务质量基线。这个基线必须由你的 Dataset、Evaluator 与生产证据建立。