核心概念与可信分数
先把四个英文概念翻成业务语言
| 概念 | 中文解释 | 在 Harbor 中回答的问题 |
|---|---|---|
| Dataset(评测数据集) | 一组带任务说明、输入与期望证据的业务样本;它定义“要测什么”,不等于把一堆聊天记录直接交给模型。 | 哪些能力必须做好?哪些失败必须被发现? |
| Generator(生成器) | 接收 Task,在固定 Candidate、模型与运行环境下生成回答或 Artifact 的执行者。它可以是 LLM Agent,也可以是脚本、工作流或其他程序。 | 谁来答、怎样运行、产出什么? |
| Evaluator(评估器) | 根据 criterion(评测标准)与 Evidence(证据)判断输出质量的机制;既可以是确定性脚本,也可以是 llm-as-judge。 | 什么叫“好”?现有证据足够下结论吗? |
| Optimizer(优化器) | 阅读 Dataset 级结果和逐 Trial 证据,提出一个受约束、可审查的改动。它不能自己宣布成功,也不能绕过回归评测和 Gate。 | 根据失败改哪里?如何避免一次改太多? |
Harbor 会把这四个用户概念编译为更严格的 Evaluation Stack,其中还包括 Integration、Renderer、Judge、Contract、Reporter、Policy、Context 与 Gate。用户先描述业务问题即可,不需要先填写内部架构问卷。
Harbor 语境中的 Dataset 首先是评测集。它是否承担训练、验证或最终测试职责,取决于数据治理规则,而不取决于目录名。相同样本不能在不披露的情况下既指导优化,又被当作“从未见过”的最终测试证据。
训练集、验证集、测试集的一般理念
机器学习把数据分开,不是为了多建三个文件夹,而是为了控制信息泄漏:优化过程究竟看过哪些信息,最终分数还能否代表未知样本。
训练集(training set)
训练集用于直接学习或改进。传统机器学习用它更新参数;Agent 工程也可以用它定位 badcase、修改 prompt、Skill、工具策略、代码或检索配置。
- 可以反复查看输入、输出和错误原因;
- 可以据此提出优化假设;
- 分数适合说明“这批已知问题是否被修复”,不适合单独证明泛化;
- 从 Historical Session 提炼出的 reviewed badcase,通常先进入这一层,而不是直接成为晋级测试集。
验证集 / 开发集(validation or development set)
验证集用于比较方案、选择阈值和停止时机。它不直接更新模型参数,但优化器会反复看到验证结果,因此也会逐渐对它过拟合。
- 用于在多个 Candidate 或配置之间做选择;
- 用于调整 Evaluator rubric、Policy 阈值或运行参数时,必须记录这种使用;
- 可以作为迭代回归集,但不应无限次调参后仍宣称它是独立最终证明;
- Harbor 的 comparable baseline 与 Candidate regression 可以运行在固定验证集上,但结果的用途必须明确标为“开发决策”还是“晋级证据”。
测试集 / 留出集(test or holdout set)
测试集用于估计最终泛化能力。Optimizer、Candidate 作者和 Evaluator 调参过程在最终运行前不应接触它的答案、Ground Truth 或逐题反馈。
- 在 Candidate、Evaluator、Policy 与运行身份冻结后再运行;
- 尽量减少重复查看和重复试跑;
- 一旦结果被用于指导下一轮修改,这批数据就不再是严格意义上的“未见测试集”,应降级为开发数据并换新的 holdout;
- Promotion Gate 只有在 baseline 与 Candidate 使用相同的不可变 Dataset、Stack、Context 和有效证据时,才具有可比意义。
一个适合 Agent 的数据分层
| 数据层 | 主要用途 | 谁可以看到反馈 | 在插件中的典型路径 |
|---|---|---|---|
| Historical 诊断样本 | 发现真实失败模式、形成假设 | 人与诊断 Judge | 预览最近完成 Session → 披露边界 → 非晋级 Historical Job |
| 训练 / 修复集 | 修复已知 badcase | Optimizer 与开发者 | 把已审查问题整理为 Task,运行诊断与局部回归 |
| 验证 / 回归集 | 比较 Candidate、选择方案 | Optimizer 可看到聚合和 Trial 证据 | 固定 Candidate/Dataset/Stack/Context 后运行 comparable Job |
| 测试 / holdout 集 | 最终泛化检查与晋级依据 | 最终运行前不向 Optimizer 暴露答案 | 冻结身份后运行 promotion-eligible Job,再执行确定性 Gate |
| Evaluator 元评测集 | 判断“尺子”是否可靠 | Evaluator 治理流程 | 独立 Ground Truth + 重复 observation → ESF / SCE / RCR |
小数据项目也应保留这些逻辑边界。即使样本量不足以做统计意义上的三等分,也要记录哪些 case 已被用于修改 Candidate、哪些用于选择方案、哪些仍然留出。
Generator:被测的生成过程
Generator 不只是“某个模型名称”,而是完整的生成过程:
- Candidate 中的 prompt、Skill、代码、工具与依赖;
- Candidate model binding 与 provider/model 身份;
- Task instruction、Context 与输入 Artifact;
- Host 或 Docker 执行环境;
- 最终 output、结构化结果和 Artifact。
本项目的 Python Adapter 把 DSH Candidate 与 Task 接到 Harbor Generator 接口;Plugin 和 Skill 在昂贵运行前冻结相关身份。模型相同但 prompt、工具、依赖或运行环境不同,仍应视为不同的生成条件。
Evaluator:把“好”写成可检查的判断
Evaluator 把业务目标拆成有身份的 Criteria,并为每条 criterion 定义 Evidence 要求。harbor-dsh-evaluator/v1 支持确定性 script 与 llm-as-judge 两种实现,但两者都必须返回可区分的状态:
- valid score:contract 与证据要求满足,分数可以进入聚合;
- invalid score:即使存在数字,也不能用于质量结论;
- abstention:Evaluator 明确表示当前证据不足以判断;
- coverage:目标 population 中有多少产生了可用证据。
Judge 只是 Evaluator 的一种实现,不是天然正确的“裁判”。模型版本、rubric、解析逻辑和实现源码都属于 Evaluator 身份;修改后必须产生新的 Evaluator 与 Evaluation Stack 版本。
Optimizer:基于证据提出一次受控改动
Optimizer 消费的是失败模式和证据,不是一个脱离上下文的平均分。插件的受控路径强调:
- 先从 Trial 与 criterion Evidence 找到可重复问题;
- 明确这次允许改变的表面,例如 prompt、Skill、Evaluator source 或代码;
- 一次只提出一个可审查改动,并生成新的 Candidate 或 Evaluator 身份;
- 在固定 Dataset 与 Stack 上重新运行;
- 由 Policy 和 Gate 判断是否满足晋级条件。
Ask AI、Action Draft 或 Optimizer proposal 都只是建议。它们不会自动写文件、启动 Job、运行 Gate 或部署;高影响动作仍需精确预检与用户确认。
元评测:先证明“尺子”值得信任
普通评测问:“Generator 的答案好吗?”元评测问:“Evaluator 的判断可靠吗?”
插件把重复 Evaluator observations 与独立 Ground Truth 对比,Ground Truth 可以来自 human、programmatic、consensus、model 或 external,但必须记录 provenance,并与被测 Evaluator 保持独立。结果包括:
- ESF(Evaluator Score Fidelity):Evaluator 与 Ground Truth 的符合程度;
- SCE(Score Calibration Error):分数置信度与真实正确率之间的校准误差;
- RCR(Ranking Consistency / Reliability):排序是否稳定、是否与 Ground Truth 一致。
Evaluator 也会过拟合。用于改 rubric、prompt 或阈值的样本属于 evaluator tuning set;用于最终证明评估器质量的样本应是独立 holdout。不能用 Candidate Evaluator 自己生成的标签,再反过来证明自己正确。
插件如何把五个环节连起来
- Dataset:校验 manifest、Task 唯一性、路径与 immutable source digest。
- Generator:冻结 Candidate manifest、模型绑定、Context 与执行环境后生成 Trial output。
- Evaluator:按 Criteria 生成 observation、Evidence、validity 与 coverage。
- Optimizer:从已审查证据提出一个新版本改动,不直接控制 verdict。
- Meta-Evaluation:用独立 Ground Truth 检查 Evaluator 本身。
- Gate:只对固定、可比输入执行确定性 Policy,输出
PROMOTE或REJECT建议。
Historical 路径帮助构造问题假设和后续数据集,但它本身是 non-promotion evaluation;Candidate 路径才可能在满足可比性、有效性与 Policy 时形成晋级证据。
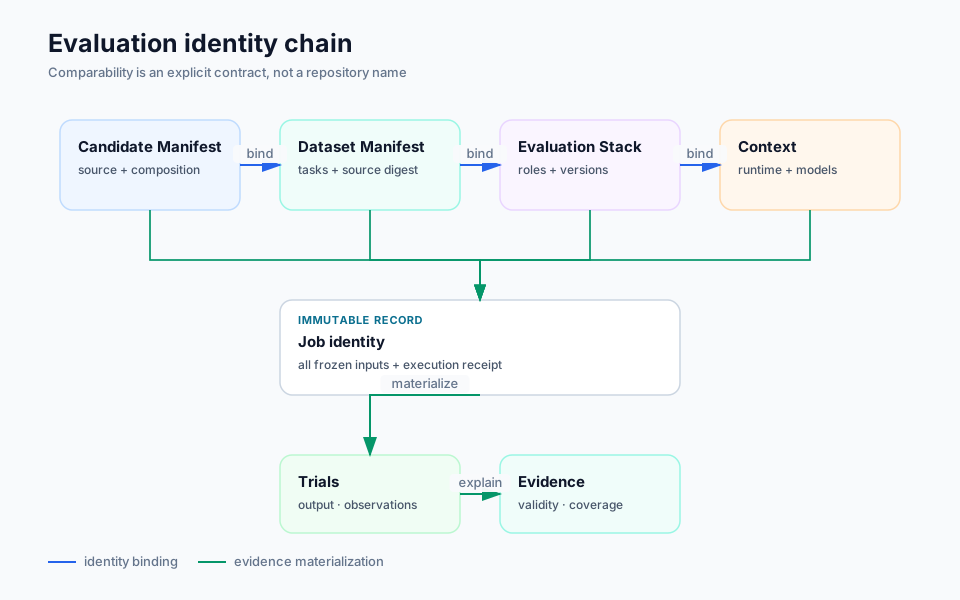
身份链
可比 Job 绑定不可变或版本化身份:Candidate Manifest、Dataset Manifest、Evaluation Stack、Context、执行环境、Candidate model binding 与 Judge identity。Trial 属于一个 Job,并携带 output、criterion observation、Evidence 与 Artifact。
Raw reward 不等于 valid score
即使缺少必要证据、解析失败或 criterion abstain,verifier 仍可能输出数字 raw reward。不展示 validity 与 coverage 的平均值,可能奖励一条坏掉的流水线。
PROMOTE 与 REJECT
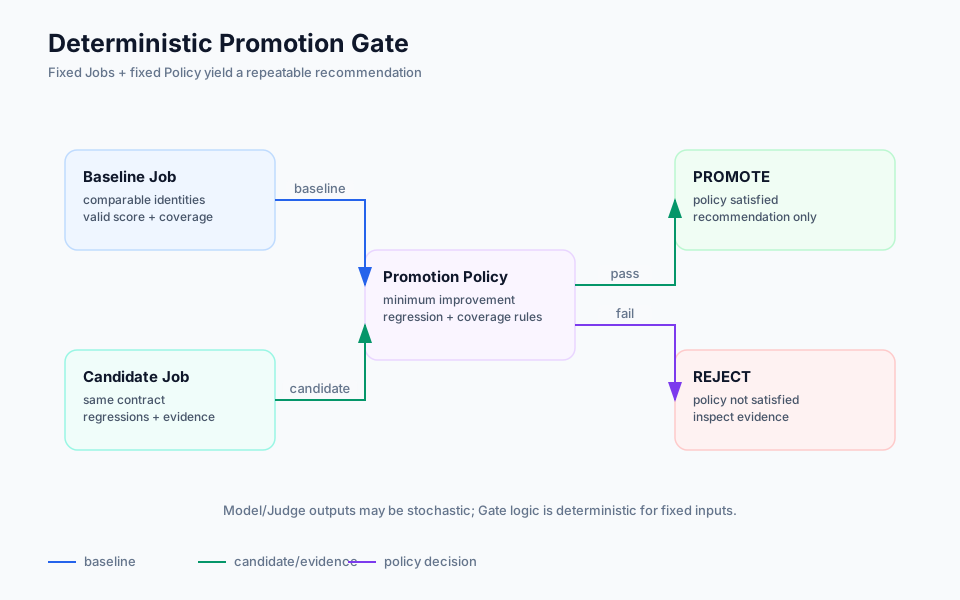
确定性 Gate 评估固定 Job 与 Policy 输入。PROMOTE 表示相对可比 baseline 满足 Policy;REJECT 表示不满足。两者都不代表“已部署”,也不替代人工或 CI/CD 权限。