这是本节的多页打印视图。 .
工作流
1 - 评测最近 Session
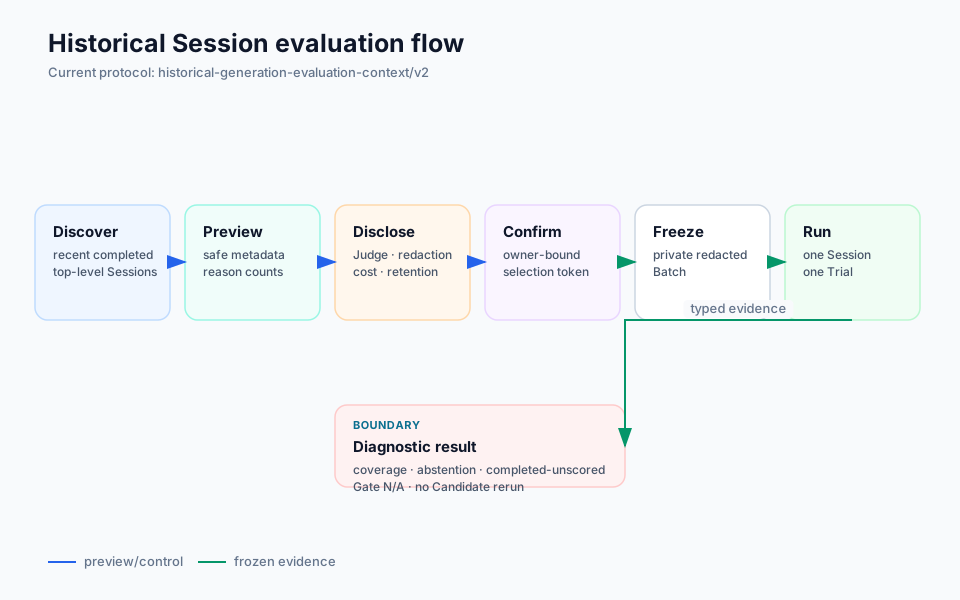
当你已有真实 Agent 交互、却没有整理好的 Dataset 时,Historical evaluation 是冷启动入口。它用于诊断,不是晋级证据。
Web 路径
- 在 DSH Harbor 页面打开 Historical Sessions。
- 预览当前 DSH 工作区可见、最近完成的顶层 Session,最多 3 条。
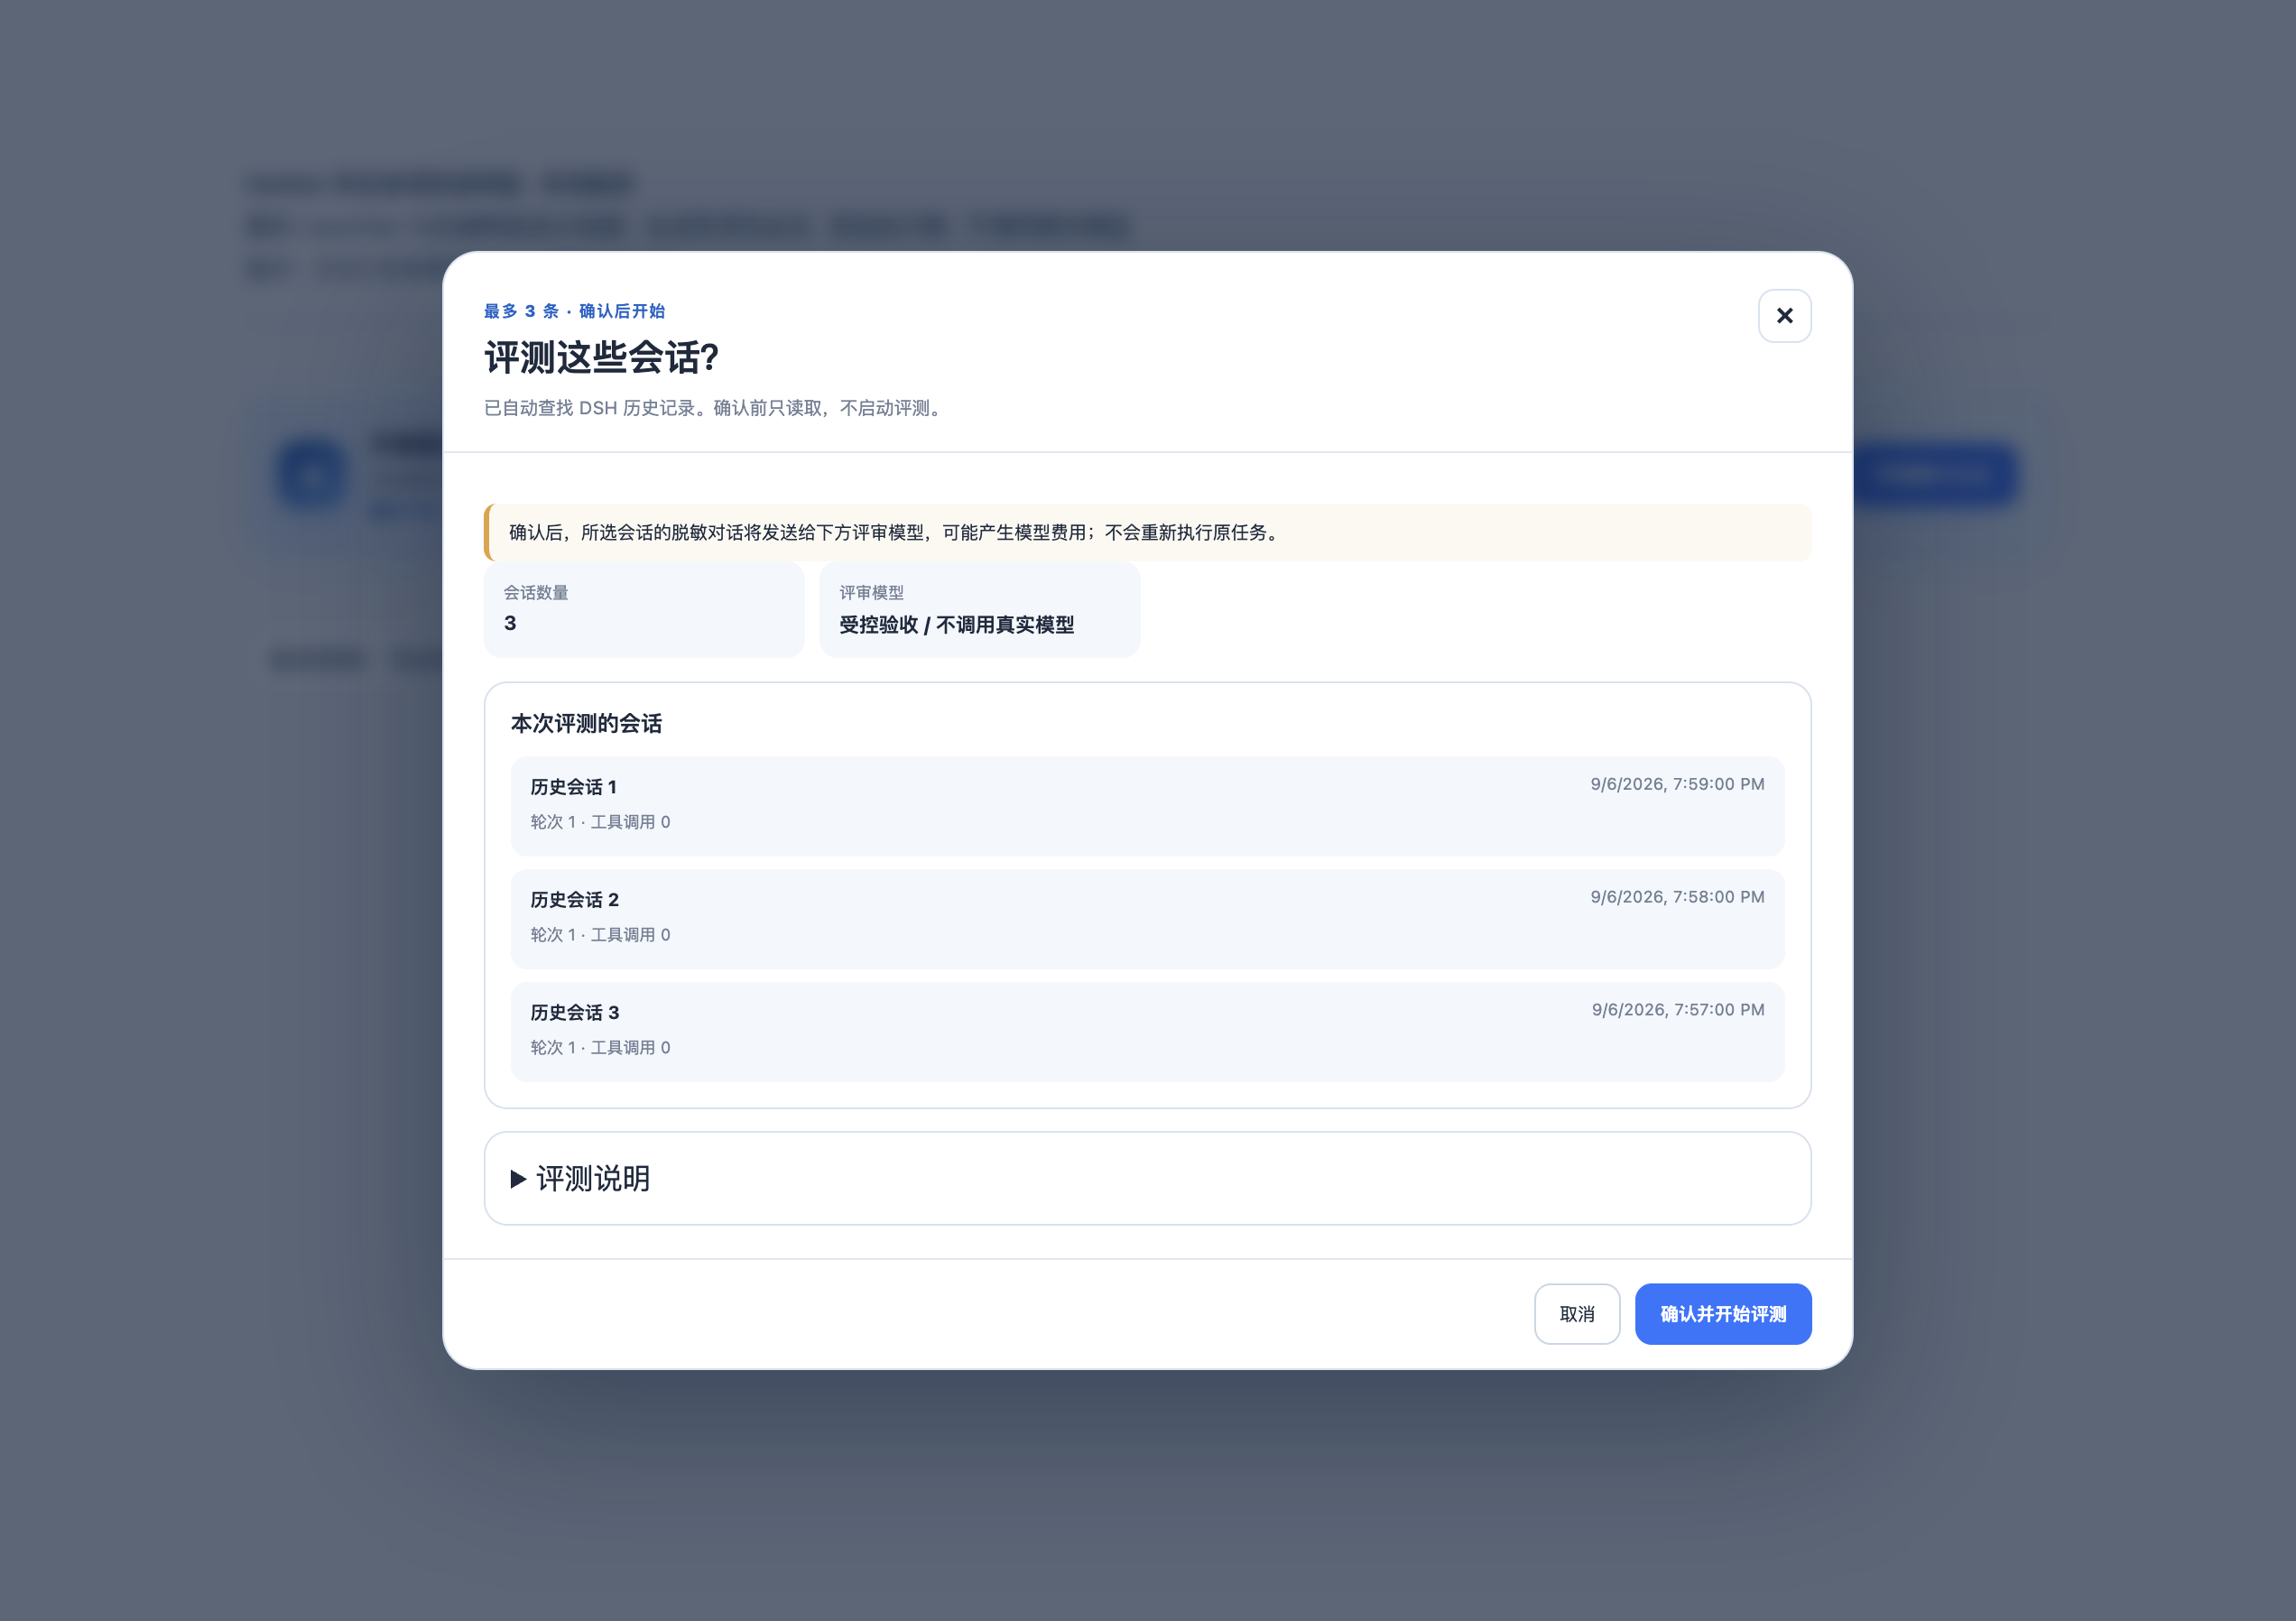
- 检查冻结的 Judge 身份、投影字段、脱敏策略以及成本/数据披露。
- 选择 Session 并确认。
- Plugin 写入私有脱敏 Batch,每条 Session 物化为一个 Harbor Trial,并启动非晋级 Historical Job。
Agent 工具路径最多预览 10 条,但只允许 exact current working directory。Preview 返回安全 metadata 与短期 owner-bound selection token,而不是原始 Session id 或 transcript。
哪些数据会交给 Judge
经过限量、投影和 credential-shaped 脱敏的证据可以发送给所选 Judge。原始 Session id、完整工具 payload、reasoning 与附件不会直接作为 Judge 输入。私有 Batch 与 Job Artifact 留在本地,可能包含业务证据和普通绝对路径。
因此不能宣传“数据永不离开本机”。
如何读结果
- 每条所选 Session 生成一个 Trial;
- criterion 可以 valid、invalid 或 abstained;
- 除分数外,还要看 coverage 与 reason code;
completed-unscored是有意义的结果,不是成功;- Candidate rerun、可比 baseline 与 Gate 对此路径不适用。
把重复 badcase 整理成 Dataset,再进入 Candidate 流水线。
恢复边界
当前 Historical Web operation 状态与锁是进程内的。Host 重启后,即使磁盘 Artifact 仍在,也可能无法重新挂接。这与 durable @harbor snapshot 和其他 operation journal 不同,必须按 operation 说明恢复保证。
2 - Candidate 评测与晋级
Candidate evaluation 比 Historical 诊断回答的问题更窄:在可比评测条件下,单个受控改动是否改善了固定业务任务?
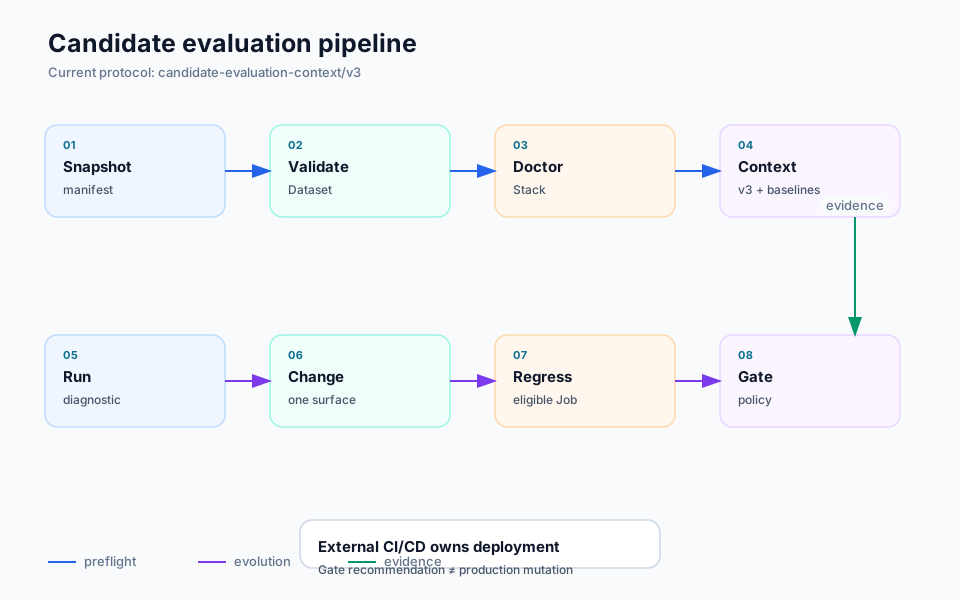
严格顺序
- 把 Candidate snapshot 为不可变 manifest。
- 验证 Dataset 身份、Task 唯一性、路径、敏感 metadata 与 source digest。
- 对 Candidate、Dataset、Evaluation Stack 和可选 Promotion Policy 运行 Doctor。
- 在昂贵 Job 前预览 Context v3 并发现可比 baseline。
- 新 Stack 或 provider 路径先跑 diagnostic。
- 只改变一个受控面:Agent 或 Evaluator,不能静默同时修改。
- 使用固定身份运行 promotion-eligible regression。
- 检查 progress、Trial output、criterion evidence 与 governance impact。
- 与可比 baseline Compare + Gate。
可比性
只使用同一个仓库,不代表 baseline 可比。Candidate manifest、Dataset manifest、Evaluation Stack、Context、执行环境以及相关 model/Judge 身份必须满足契约。Dataset digest、Stack 版本、provider 身份或 runtime 边界变化都可能要求新 baseline。
Gate
对固定 baseline Job、Candidate Job 与 policy 输入,Gate 是确定性的。它根据 valid score 变化、最小改进、回归、coverage 等 policy 条件返回 PROMOTE 或 REJECT。
它不会部署、修改 Champion 或绕过外部 CI/CD 批准。
0.9.7 已在 Dashboard overview 与 Job detail 中接受 Candidate Context v3。Compare/Gate 仍由 Artifact 有效性、身份可比性、mode 与 policy 控制。
发布测试不能证明什么
0.9.7 未运行真实供应商模型、真实 Candidate/Historical Session 数据或付费 Harbor 评测;自动化测试结论不构成业务质量基线。这个基线必须由你的 Dataset、Evaluator 与生产证据建立。
3 - Evaluator 治理与元评测
Candidate 质量与 Evaluator 质量是两个独立治理问题。
接口与检查
正式 Candidate Evaluator 实现 harbor-dsh-evaluator/v2。Descriptor 标识 implementation kind(script 或 llm-as-judge)、ternary Criteria,以及 bounded editable source allowlist。Inspection 会省略 secret-shaped 与 local-path-shaped 值。
受控更新
Evaluator update 在 optimistic concurrency 下替换一个 descriptor-authorized source file。调用方提供 expected digest 以及新的 Evaluator 和 Stack 版本。更新不会自动运行评测或 Gate。
独立 Ground Truth
Ground Truth 可以来自 human、programmatic、consensus、model 或 external,但 provenance 必须明确,并且独立于 Candidate Evaluator。Draft non-overwriting,并标明覆盖哪些 criterion。
元评测
把重复 Evaluator observation 与独立 Ground Truth 对比,生成:
- ESF:evaluator score fidelity;
- SCE:score calibration error;
- RCR:ranking consistency/reliability。
Evaluator 自己也需要训练、验证与测试边界
评估器的 rubric、Judge prompt、解析器和阈值都可能被“训练”:
- tuning set:用于发现漏判、误判并修改 rubric、prompt 或脚本;
- validation set:用于比较多个 Evaluator 版本、选择阈值与实现;
- meta-evaluation holdout:在版本冻结后才揭示的独立样本,用于估计 Evaluator 对未知 case 的可靠性。
如果同一批人工标签既指导修改 Evaluator,又被用于最终宣称“评估器准确”,结果会有信息泄漏。人工 raw review 必须保持独立 provenance,不能被改写成 Candidate Evaluator 的输出。
在插件中的治理顺序
harbor_evaluator_inspect读取接口、Criteria 与允许修改的源码边界;harbor_ground_truth_init创建 non-overwriting、带 provenance 的独立 Ground Truth 草稿;harbor_evaluator_meta_evaluate比较重复 observations 与 Ground Truth,写出 ESF、SCE、RCR;- 只有证据支持时,
harbor_evaluator_update才以 expected digest 更新一个授权文件,并强制新的 Evaluator / Stack 版本; - 更新后重新运行 tuning 与 holdout 元评测,再决定是否让新 Evaluator 参与 Candidate 评测。
元评测不会自动修改 Evaluator,也不会运行 Candidate Gate。Historical evaluation 还是不同场景:真实 Session 未必触发每条 criterion,因此 applicability、coverage 与 abstention 很重要。