这是本节的多页打印视图。 .
文档
- 1: 安装与开始
- 2: 工作流
- 2.1: 评测最近 Session
- 2.2: Candidate 评测与晋级
- 2.3: Evaluator 治理与元评测
- 3: Workbench、上下文与受审动作
- 4: 核心概念与可信分数
- 5: 架构与信任边界
- 6: 参考
- 6.1: 19 个 Harbor Agent 工具
- 7: 安全、隐私与执行边界
- 8: 故障排查
选择与你的问题匹配的路径:
- 安装并开始:把 Plugin、Adapter 与 Skill 安装到选定 DSH profile。
- Historical 诊断:从最近完成的 Session 学习,但不把它当晋级证据。
- Candidate 评测:冻结身份,运行可比回归并应用 policy。
- Plugin Workbench:理解 Context、Evidence、Artifact 与受审动作。
- 核心概念:理解 valid score、raw reward 与 coverage 为何不可互换。
- 架构:检查协议、执行环境与信任边界。
- 19 工具参考:查阅每个 Agent 工具与批准边界。
- 安全:运行不可信 Task 前先了解限制。
版本基线:Harbor Self-Evolving 0.9.7(Beta),兼容 Harbor >=0.21,<0.22。未打 tag checkout 的开发预览行为单独标注。
1 - 安装与开始
要求
- 可用的 DeepSeek Harness,以及要评测的业务 Agent 工作区。
- 用于 DSH Plugin setup 的 Node.js/npm。
- 安装 Adapter 所需的 Python 环境支持。
- Harbor
>=0.21,<0.22。 - 只有显式选择容器执行时才需要 Docker;0.10.3 默认 Host。
安装
请在业务 Agent 工作区运行,不要在本源码仓库运行:
需要固定版本时,把 latest 换成 0.10.3。Setup 会写入选定 DSH profile 依赖、配置 Harbor 项目集成、安装兼容 Python Adapter,并暴露内置 evolve-agent-with-harbor Skill。随后执行 setup 打印的精确重启命令。
普通安装不要使用 dsh plugin add ./packages/dsh-plugin。这会产生机器本地 link: 依赖,并漏掉 Adapter setup。
验证
重启后验证三个面:
- 选定 profile 依赖精确 registry 版本
"dsh-harbor-evolution": "0.10.3",而不是link:...; harbor plugins list同时包含dsh-evolution与dsh-historical-evaluation;- 内置
evolve-agent-with-harborSkill 存在。
然后打开 DSH 的 Harbor 导航入口。健康安装会在原生界面中暴露 Workbench、Historical Sessions、Context 与 Settings,而不是另起独立 Web server。
选择第一条路径
**还没有 Dataset?**从 Historical 诊断开始。Web 最多预览 3 条最近完成 Session(Agent 工具在 exact cwd 下最多 10 条),检查脱敏/Judge 披露后确认非晋级 Job。
**已有 Candidate 与 Dataset?**按照 Candidate 评测执行 snapshot、validate、doctor、Context preview、可比 baseline、单个受控回归和 Gate。
源码开发
只有修改本仓库的贡献者才应 clone 并运行:
源码 build 可能包含未发布行为,不能当作正式 0.10.3 包。早期未打 tag 的一键更新预览已在 0.9.7 前撤回;浏览器只检查版本并复制完整、可审阅的终端命令。
2.1 - 评测最近 Session
当你已有真实 Agent 交互、却没有整理好的 Dataset 时,Historical evaluation 是冷启动入口。它用于诊断,不是晋级证据。
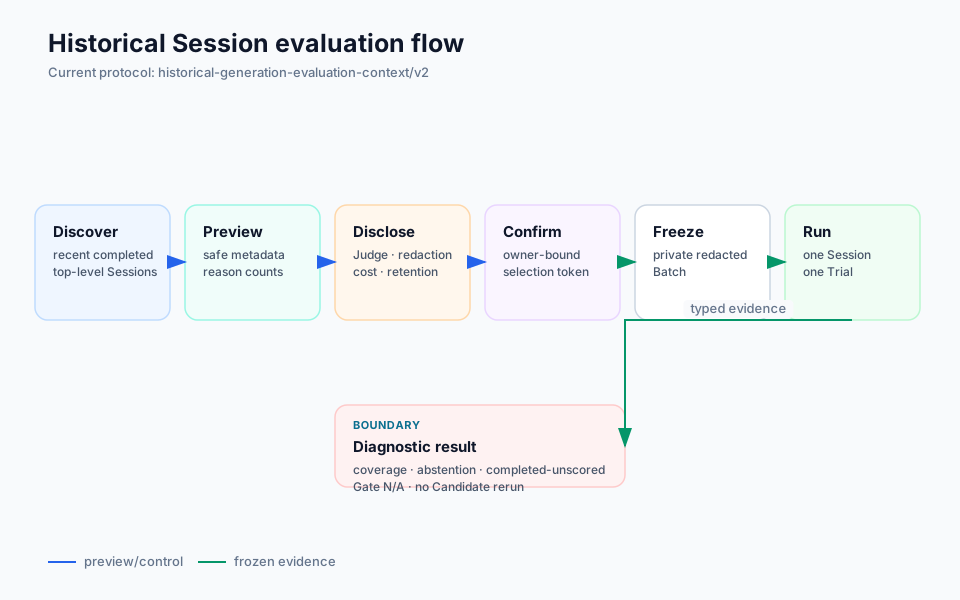
Web 路径
- 在 DSH Harbor 页面打开 Historical Sessions。
- 预览当前 DSH 工作区可见、最近完成的顶层 Session,最多 3 条。
- 检查冻结的 Judge 身份、投影字段、脱敏策略以及成本/数据披露。
- 选择 Session 并确认。
- Plugin 写入私有脱敏 Batch,每条 Session 物化为一个 Harbor Trial,并启动非晋级 Historical Job。
Agent 工具路径最多预览 10 条,但只允许 exact current working directory。Preview 返回安全 metadata 与短期 owner-bound selection token,而不是原始 Session id 或 transcript。
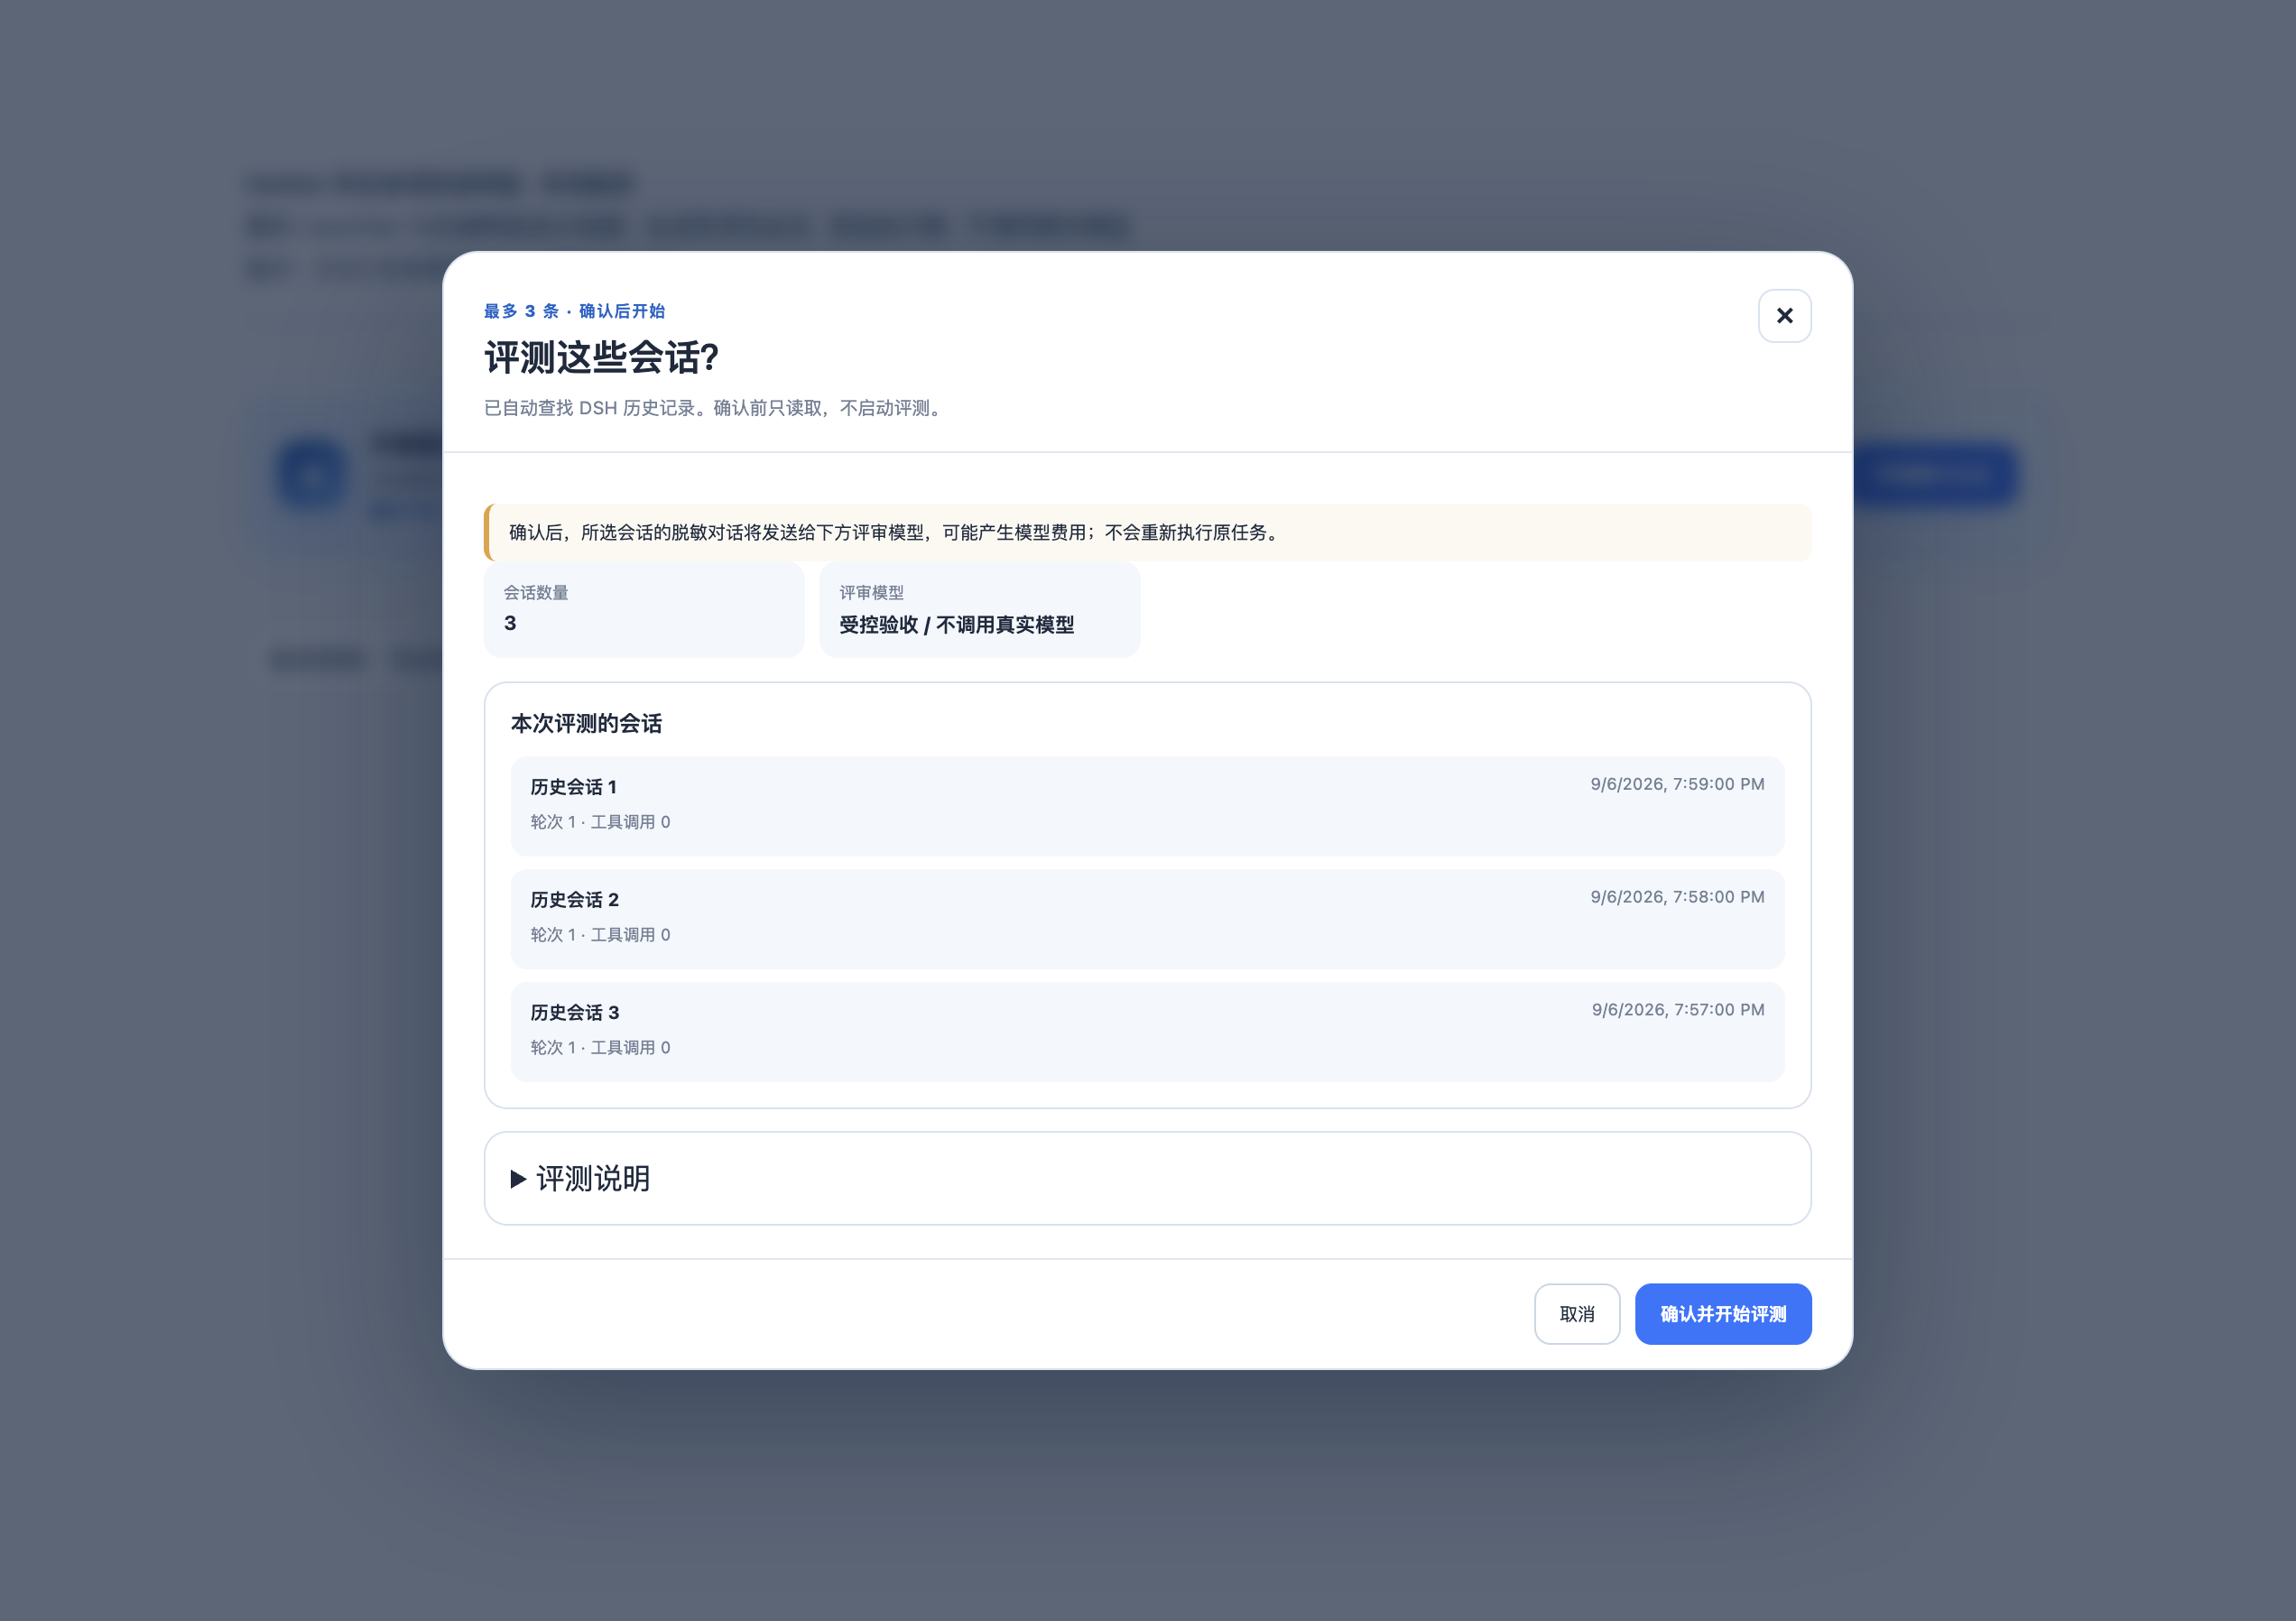
哪些数据会交给 Judge
经过限量、投影和 credential-shaped 脱敏的证据可以发送给所选 Judge。原始 Session id、完整工具 payload、reasoning 与附件不会直接作为 Judge 输入。私有 Batch 与 Job Artifact 留在本地,可能包含业务证据和普通绝对路径。
因此不能宣传“数据永不离开本机”。
如何读结果
- 每条所选 Session 生成一个 Trial;
- criterion 可以 valid、invalid 或 abstained;
- 除分数外,还要看 coverage 与 reason code;
completed-unscored是有意义的结果,不是成功;- Candidate rerun、可比 baseline 与 Gate 对此路径不适用。
把重复 badcase 整理成 Dataset,再进入 Candidate 流水线。
恢复边界
当前 Historical Web operation 状态与锁是进程内的。Host 重启后,即使磁盘 Artifact 仍在,也可能无法重新挂接。这与 durable @harbor snapshot 和其他 operation journal 不同,必须按 operation 说明恢复保证。
2.2 - Candidate 评测与晋级
Candidate evaluation 比 Historical 诊断回答的问题更窄:在可比评测条件下,单个受控改动是否改善了固定业务任务?
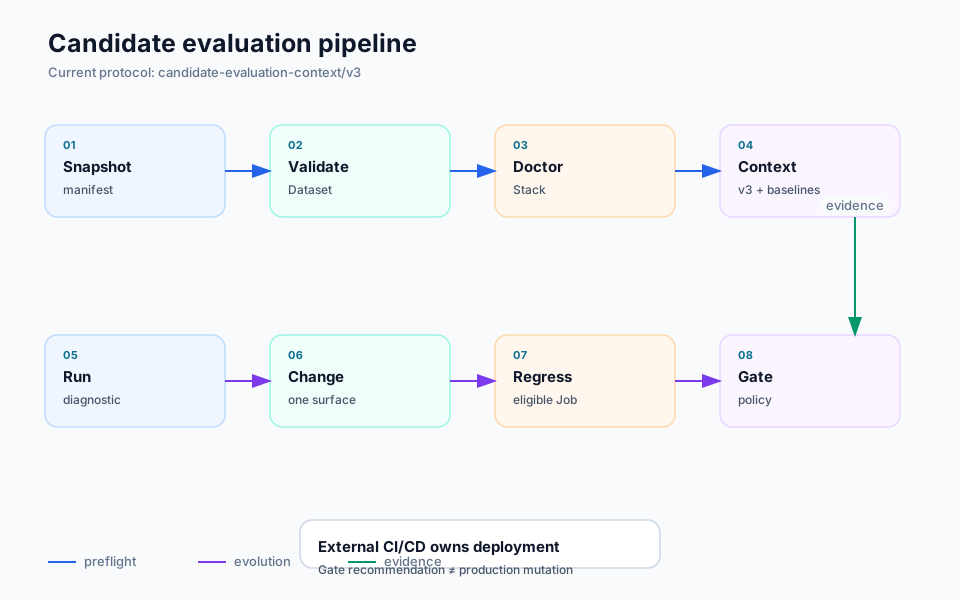
严格顺序
- 把 Candidate snapshot 为不可变 manifest。
- 验证 Dataset 身份、Task 唯一性、路径、敏感 metadata 与 source digest。
- 对 Candidate、Dataset、Evaluation Stack 和可选 Promotion Policy 运行 Doctor。
- 在昂贵 Job 前预览 Context v3 并发现可比 baseline。
- 新 Stack 或 provider 路径先跑 diagnostic。
- 只改变一个受控面:Agent 或 Evaluator,不能静默同时修改。
- 使用固定身份运行 promotion-eligible regression。
- 检查 progress、Trial output、criterion evidence 与 governance impact。
- 与可比 baseline Compare + Gate。
可比性
只使用同一个仓库,不代表 baseline 可比。Candidate manifest、Dataset manifest、Evaluation Stack、Context、执行环境以及相关 model/Judge 身份必须满足契约。Dataset digest、Stack 版本、provider 身份或 runtime 边界变化都可能要求新 baseline。
Gate
对固定 baseline Job、Candidate Job 与 policy 输入,Gate 是确定性的。它根据 valid score 变化、最小改进、回归、coverage 等 policy 条件返回 PROMOTE 或 REJECT。
它不会部署、修改 Champion 或绕过外部 CI/CD 批准。
0.9.7 已在 Dashboard overview 与 Job detail 中接受 Candidate Context v3。Compare/Gate 仍由 Artifact 有效性、身份可比性、mode 与 policy 控制。
发布测试不能证明什么
0.9.7 未运行真实供应商模型、真实 Candidate/Historical Session 数据或付费 Harbor 评测;自动化测试结论不构成业务质量基线。这个基线必须由你的 Dataset、Evaluator 与生产证据建立。
2.3 - Evaluator 治理与元评测
Candidate 质量与 Evaluator 质量是两个独立治理问题。
接口与检查
正式 Candidate Evaluator 实现 harbor-dsh-evaluator/v2。Descriptor 标识 implementation kind(script 或 llm-as-judge)、ternary Criteria,以及 bounded editable source allowlist。Inspection 会省略 secret-shaped 与 local-path-shaped 值。
受控更新
Evaluator update 在 optimistic concurrency 下替换一个 descriptor-authorized source file。调用方提供 expected digest 以及新的 Evaluator 和 Stack 版本。更新不会自动运行评测或 Gate。
独立 Ground Truth
Ground Truth 可以来自 human、programmatic、consensus、model 或 external,但 provenance 必须明确,并且独立于 Candidate Evaluator。Draft non-overwriting,并标明覆盖哪些 criterion。
元评测
把重复 Evaluator observation 与独立 Ground Truth 对比,生成:
- ESF:evaluator score fidelity;
- SCE:score calibration error;
- RCR:ranking consistency/reliability。
Evaluator 自己也需要训练、验证与测试边界
评估器的 rubric、Judge prompt、解析器和阈值都可能被“训练”:
- tuning set:用于发现漏判、误判并修改 rubric、prompt 或脚本;
- validation set:用于比较多个 Evaluator 版本、选择阈值与实现;
- meta-evaluation holdout:在版本冻结后才揭示的独立样本,用于估计 Evaluator 对未知 case 的可靠性。
如果同一批人工标签既指导修改 Evaluator,又被用于最终宣称“评估器准确”,结果会有信息泄漏。人工 raw review 必须保持独立 provenance,不能被改写成 Candidate Evaluator 的输出。
在插件中的治理顺序
harbor_evaluator_inspect读取接口、Criteria 与允许修改的源码边界;harbor_ground_truth_init创建 non-overwriting、带 provenance 的独立 Ground Truth 草稿;harbor_evaluator_meta_evaluate比较重复 observations 与 Ground Truth,写出 ESF、SCE、RCR;- 只有证据支持时,
harbor_evaluator_update才以 expected digest 更新一个授权文件,并强制新的 Evaluator / Stack 版本; - 更新后重新运行 tuning 与 holdout 元评测,再决定是否让新 Evaluator 参与 Candidate 评测。
元评测不会自动修改 Evaluator,也不会运行 Candidate Gate。Historical evaluation 还是不同场景:真实 Session 未必触发每条 criterion,因此 applicability、coverage 与 abstention 很重要。
3 - Workbench、上下文与受审动作
Harbor 页面注入现有 DSH Web GUI,复用 DSH locale、Session、conversation、composer、Settings 与 Tool View;它不是第二个聊天产品或登录系统。
Object-first Workbench
一个 Job 连接八个 section:Summary、Trials、Pipeline、Optimization、Compare/Gate、Evaluator/Rubric、Artifacts、Audit。Pipeline 把 Candidate、Dataset、Integration、Renderer、Judge、Meta、Reporter、Optimizer、Gate 分开,避免把接线失败误报为低分。
Trial explorer 支持服务端分页、状态与 score-validity filter、排序、criterion evidence focus 与冻结 Trial set。业务 Artifact 始终附着在产出它的 Trial 上。
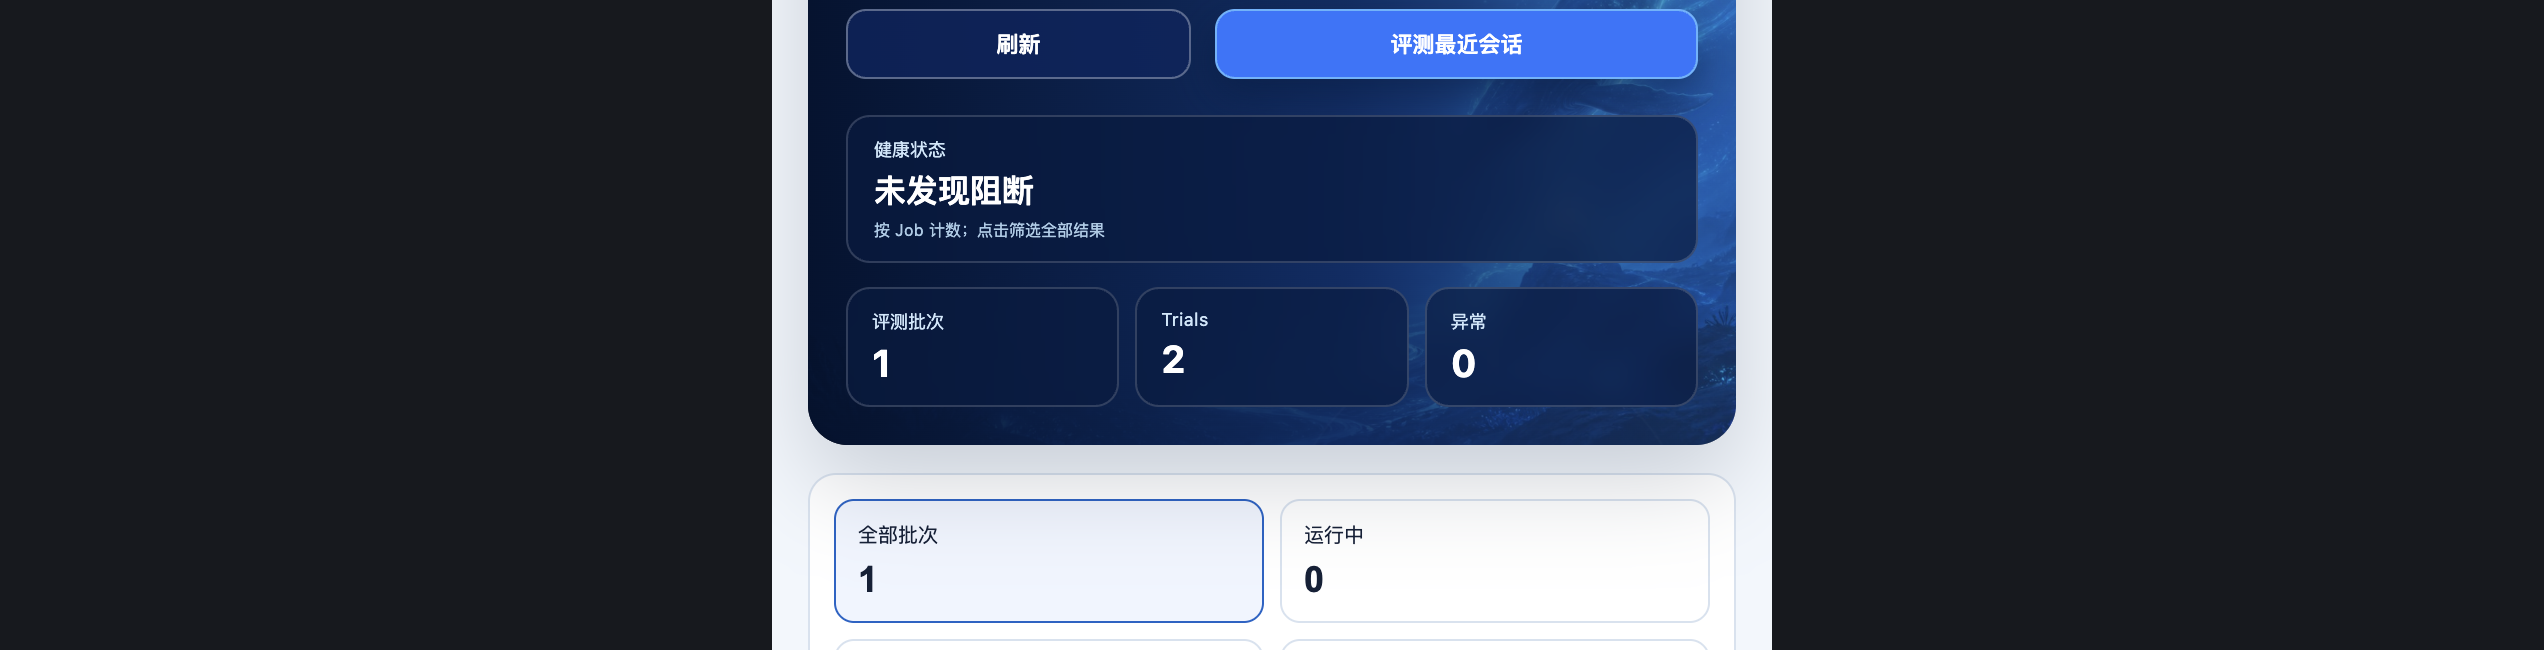
页面上下文
Host 支持时,普通发送会冻结当前 Harbor 页面上下文。Ask AI 或显式 @harbor 引用优先,而且 one-shot。Host 为精确 Session、project 与 revision 解析 opaque token,再返回 typed refs 与 navigation action。Evidence 读取验证完整祖先链,并把内容视为不可信数据。
受审动作
七类 draft 覆盖 Candidate change、Evaluator change、Compare、Diagnostic Evaluation、Infrastructure Retry、Gate Request 与 Deployment Handoff。Proposal 不是授权。
- 用户显式请求动作。
- AI 从新鲜页面上下文创建可过期 draft。
- 确定性 preflight 展示 target、diff、身份与限制。
- 用户确认精确动作。
- Host journal 执行并展示 progress/recovery 状态。
Candidate/Gate/handoff draft 不会静默执行;Compare 只读;未注册生产动作直接拒绝。
Settings 与 operation
Settings 展示 project root 来源、Stack/jobs/CLI 检查、credential policy、执行环境与版本状态。Agent 工具仍以调用 Session cwd 为权威;process-local Settings root 主要服务 Web 与 fallback。
后台 operation 可以显示 progress、partial evidence、取消与导航,但持久化能力因 operation 而异。未知状态不能伪装为成功,失败也不能静默重试。
0.9.7 已接受 Candidate Context v3,并显式识别 Historical Context v2。Compare/Gate 仍由 Artifact 有效性、身份可比性、mode 与 policy 控制;参见 Plugin 边界。
4 - 核心概念与可信分数
先把四个英文概念翻成业务语言
| 概念 | 中文解释 | 在 Harbor 中回答的问题 |
|---|---|---|
| Dataset(评测数据集) | 一组带任务说明、输入与期望证据的业务样本;它定义“要测什么”,不等于把一堆聊天记录直接交给模型。 | 哪些能力必须做好?哪些失败必须被发现? |
| Generator(生成器) | 接收 Task,在固定 Candidate、模型与运行环境下生成回答或 Artifact 的执行者。它可以是 LLM Agent,也可以是脚本、工作流或其他程序。 | 谁来答、怎样运行、产出什么? |
| Evaluator(评估器) | 根据 criterion(评测标准)与 Evidence(证据)判断输出质量的机制;既可以是确定性脚本,也可以是 llm-as-judge。 | 什么叫“好”?现有证据足够下结论吗? |
| Optimizer(优化器) | 阅读 Dataset 级结果和逐 Trial 证据,提出一个受约束、可审查的改动。它不能自己宣布成功,也不能绕过回归评测和 Gate。 | 根据失败改哪里?如何避免一次改太多? |
Harbor 会把这四个用户概念编译为更严格的 Evaluation Stack,其中还包括 Integration、Renderer、Judge、Contract、Reporter、Policy、Context 与 Gate。用户先描述业务问题即可,不需要先填写内部架构问卷。
Harbor 语境中的 Dataset 首先是评测集。它是否承担训练、验证或最终测试职责,取决于数据治理规则,而不取决于目录名。相同样本不能在不披露的情况下既指导优化,又被当作“从未见过”的最终测试证据。
训练集、验证集、测试集的一般理念
机器学习把数据分开,不是为了多建三个文件夹,而是为了控制信息泄漏:优化过程究竟看过哪些信息,最终分数还能否代表未知样本。
训练集(training set)
训练集用于直接学习或改进。传统机器学习用它更新参数;Agent 工程也可以用它定位 badcase、修改 prompt、Skill、工具策略、代码或检索配置。
- 可以反复查看输入、输出和错误原因;
- 可以据此提出优化假设;
- 分数适合说明“这批已知问题是否被修复”,不适合单独证明泛化;
- 从 Historical Session 提炼出的 reviewed badcase,通常先进入这一层,而不是直接成为晋级测试集。
验证集 / 开发集(validation or development set)
验证集用于比较方案、选择阈值和停止时机。它不直接更新模型参数,但优化器会反复看到验证结果,因此也会逐渐对它过拟合。
- 用于在多个 Candidate 或配置之间做选择;
- 用于调整 Evaluator rubric、Policy 阈值或运行参数时,必须记录这种使用;
- 可以作为迭代回归集,但不应无限次调参后仍宣称它是独立最终证明;
- Harbor 的 comparable baseline 与 Candidate regression 可以运行在固定验证集上,但结果的用途必须明确标为“开发决策”还是“晋级证据”。
测试集 / 留出集(test or holdout set)
测试集用于估计最终泛化能力。Optimizer、Candidate 作者和 Evaluator 调参过程在最终运行前不应接触它的答案、Ground Truth 或逐题反馈。
- 在 Candidate、Evaluator、Policy 与运行身份冻结后再运行;
- 尽量减少重复查看和重复试跑;
- 一旦结果被用于指导下一轮修改,这批数据就不再是严格意义上的“未见测试集”,应降级为开发数据并换新的 holdout;
- Promotion Gate 只有在 baseline 与 Candidate 使用相同的不可变 Dataset、Stack、Context 和有效证据时,才具有可比意义。
一个适合 Agent 的数据分层
| 数据层 | 主要用途 | 谁可以看到反馈 | 在插件中的典型路径 |
|---|---|---|---|
| Historical 诊断样本 | 发现真实失败模式、形成假设 | 人与诊断 Judge | 预览最近完成 Session → 披露边界 → 非晋级 Historical Job |
| 训练 / 修复集 | 修复已知 badcase | Optimizer 与开发者 | 把已审查问题整理为 Task,运行诊断与局部回归 |
| 验证 / 回归集 | 比较 Candidate、选择方案 | Optimizer 可看到聚合和 Trial 证据 | 固定 Candidate/Dataset/Stack/Context 后运行 comparable Job |
| 测试 / holdout 集 | 最终泛化检查与晋级依据 | 最终运行前不向 Optimizer 暴露答案 | 冻结身份后运行 promotion-eligible Job,再执行确定性 Gate |
| Evaluator 元评测集 | 判断“尺子”是否可靠 | Evaluator 治理流程 | 独立 Ground Truth + 重复 observation → ESF / SCE / RCR |
小数据项目也应保留这些逻辑边界。即使样本量不足以做统计意义上的三等分,也要记录哪些 case 已被用于修改 Candidate、哪些用于选择方案、哪些仍然留出。
Generator:被测的生成过程
Generator 不只是“某个模型名称”,而是完整的生成过程:
- Candidate 中的 prompt、Skill、代码、工具与依赖;
- Candidate model binding 与 provider/model 身份;
- Task instruction、Context 与输入 Artifact;
- Host 或 Docker 执行环境;
- 最终 output、结构化结果和 Artifact。
本项目的 Python Adapter 把 DSH Candidate 与 Task 接到 Harbor Generator 接口;Plugin 和 Skill 在昂贵运行前冻结相关身份。模型相同但 prompt、工具、依赖或运行环境不同,仍应视为不同的生成条件。
Evaluator:把“好”写成可检查的判断
Evaluator 把业务目标拆成有身份的 Criteria,并为每条 criterion 定义 Evidence 要求。harbor-dsh-evaluator/v1 支持确定性 script 与 llm-as-judge 两种实现,但两者都必须返回可区分的状态:
- valid score:contract 与证据要求满足,分数可以进入聚合;
- invalid score:即使存在数字,也不能用于质量结论;
- abstention:Evaluator 明确表示当前证据不足以判断;
- coverage:目标 population 中有多少产生了可用证据。
Judge 只是 Evaluator 的一种实现,不是天然正确的“裁判”。模型版本、rubric、解析逻辑和实现源码都属于 Evaluator 身份;修改后必须产生新的 Evaluator 与 Evaluation Stack 版本。
Optimizer:基于证据提出一次受控改动
Optimizer 消费的是失败模式和证据,不是一个脱离上下文的平均分。插件的受控路径强调:
- 先从 Trial 与 criterion Evidence 找到可重复问题;
- 明确这次允许改变的表面,例如 prompt、Skill、Evaluator source 或代码;
- 一次只提出一个可审查改动,并生成新的 Candidate 或 Evaluator 身份;
- 在固定 Dataset 与 Stack 上重新运行;
- 由 Policy 和 Gate 判断是否满足晋级条件。
Ask AI、Action Draft 或 Optimizer proposal 都只是建议。它们不会自动写文件、启动 Job、运行 Gate 或部署;高影响动作仍需精确预检与用户确认。
元评测:先证明“尺子”值得信任
普通评测问:“Generator 的答案好吗?”元评测问:“Evaluator 的判断可靠吗?”
插件把重复 Evaluator observations 与独立 Ground Truth 对比,Ground Truth 可以来自 human、programmatic、consensus、model 或 external,但必须记录 provenance,并与被测 Evaluator 保持独立。结果包括:
- ESF(Evaluator Score Fidelity):Evaluator 与 Ground Truth 的符合程度;
- SCE(Score Calibration Error):分数置信度与真实正确率之间的校准误差;
- RCR(Ranking Consistency / Reliability):排序是否稳定、是否与 Ground Truth 一致。
Evaluator 也会过拟合。用于改 rubric、prompt 或阈值的样本属于 evaluator tuning set;用于最终证明评估器质量的样本应是独立 holdout。不能用 Candidate Evaluator 自己生成的标签,再反过来证明自己正确。
插件如何把五个环节连起来
- Dataset:校验 manifest、Task 唯一性、路径与 immutable source digest。
- Generator:冻结 Candidate manifest、模型绑定、Context 与执行环境后生成 Trial output。
- Evaluator:按 Criteria 生成 observation、Evidence、validity 与 coverage。
- Optimizer:从已审查证据提出一个新版本改动,不直接控制 verdict。
- Meta-Evaluation:用独立 Ground Truth 检查 Evaluator 本身。
- Gate:只对固定、可比输入执行确定性 Policy,输出
PROMOTE或REJECT建议。
Historical 路径帮助构造问题假设和后续数据集,但它本身是 non-promotion evaluation;Candidate 路径才可能在满足可比性、有效性与 Policy 时形成晋级证据。
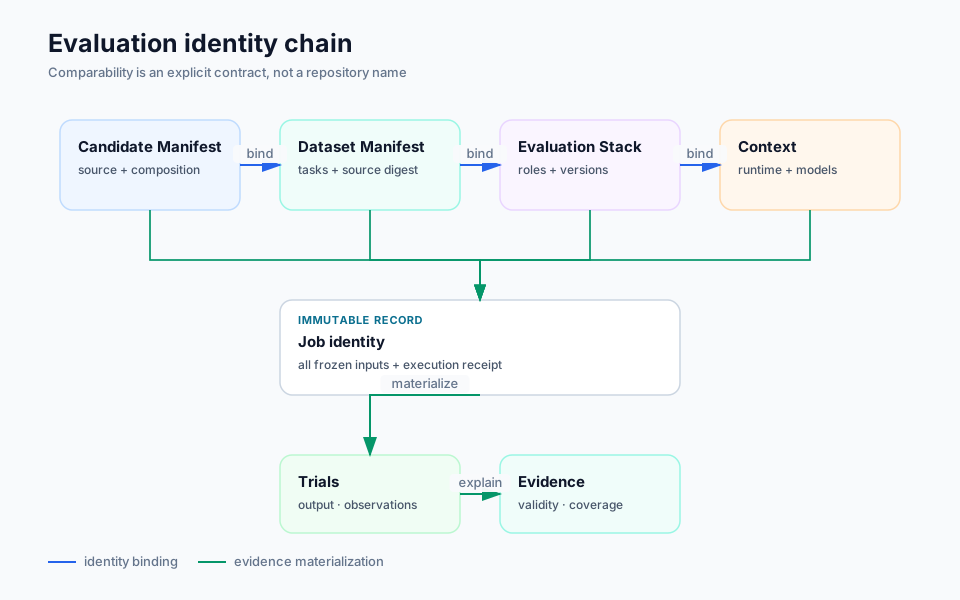
身份链
可比 Job 绑定不可变或版本化身份:Candidate Manifest、Dataset Manifest、Evaluation Stack、Context、执行环境、Candidate model binding 与 Judge identity。Trial 属于一个 Job,并携带 output、criterion observation、Evidence 与 Artifact。
Raw reward 不等于 valid score
即使缺少必要证据、解析失败或 criterion abstain,verifier 仍可能输出数字 raw reward。不展示 validity 与 coverage 的平均值,可能奖励一条坏掉的流水线。
PROMOTE 与 REJECT
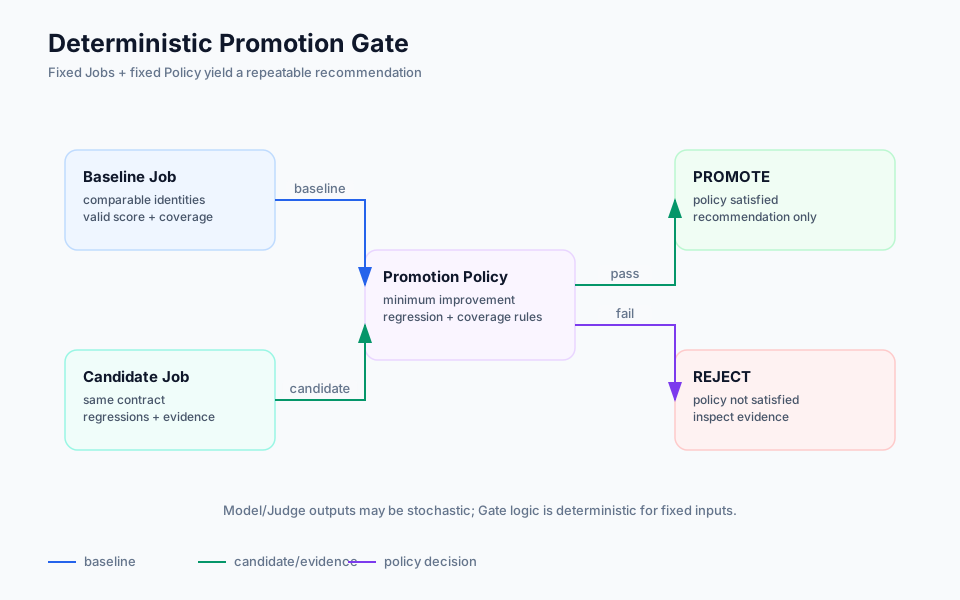
确定性 Gate 评估固定 Job 与 Policy 输入。PROMOTE 表示相对可比 baseline 满足 Policy;REJECT 表示不满足。两者都不代表“已部署”,也不替代人工或 CI/CD 权限。
5 - 架构与信任边界
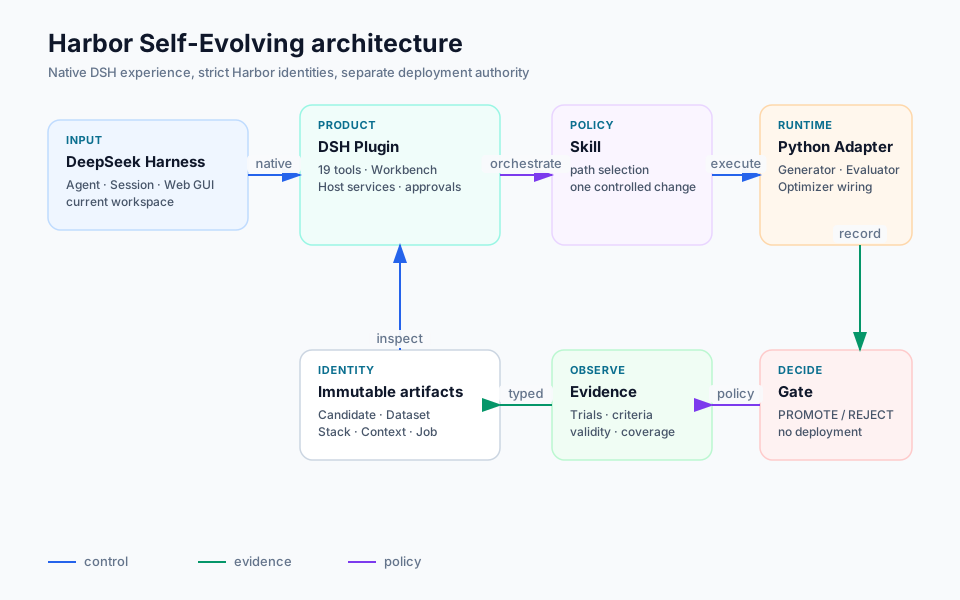
三个产品角色
- Plugin:面向用户的 DSH 集成与权限边界。
- Skill:选择最小安全评测路径的工作流 policy。
- Adapter:物化 Job、Trial、Evidence 与 Context 的 Harbor runtime bridge。
Gate 保持独立确定性 policy function;它不是 Optimizer 的一部分,也没有部署能力。
八角色 Evaluation Stack
Generator、Integration、Renderer、Evaluator/Judge、Contract、Reporter、Optimizer、Policy/Gate 把执行、观察、解释、报告、变更建议与晋级分开,避免一个不透明 prompt 同时改系统又给自己打分。
两套 Context 协议
| 协议 | Schema | 用途 |
|---|---|---|
| Candidate evaluation context | v3 | 可比 Candidate Job:manifest、runtime/model 身份、Stack 与 baseline 发现 |
| Historical generation evaluation context | v2 | 冻结脱敏 Session Batch 的非晋级诊断 |
它们共享部分身份概念,但不能互换。Historical v2 不能只因为对象写着 schema_version: 2 就被接受;必须做 protocol-aware 验证。
执行环境
0.9.7 默认 Host,Docker 为显式 opt-in。执行环境身份进入 Context,因此 Host 与 Docker 结果不会静默视为可比。
默认 Host 模式不提供容器隔离、用户切换、网络策略或 CPU/内存限制,任务以当前用户权限直接运行。
Model Broker 给 Candidate 随机、短期 Job capability,不向 Candidate 下发上游模型凭据。它限制请求数与字节数,但不能证明 Host 环境没有其他 secret,也不是 provider 计费 hard cap。
Artifact 与 Evidence 流
Task output 成为 Trial output;Evaluator 产出 observation 与 typed Evidence;先计算 validity 与 coverage,再聚合;面向 Agent 的 Job summary 与 governance view 保持 bounded、redacted。用户可从窄 typed ref 导航回精确 criterion,但不能任意读取文件。
6 - 参考
6.1 - 19 个 Harbor Agent 工具
Plugin 暴露 19 个严格工具:10 个 workspace/Job mutation 进入 DSH 一次性 approval;9 个为只读或内存操作。Host 缺少 approval seam 时,mutation tool fail closed。
| Tool | 用途与最小边界 | 模式 / 结果 |
|---|---|---|
harbor_candidate_snapshot | 把一个 Cordis composition 固定为不可变 Candidate Manifest。 | **写本地 Artifact · approval。**下一步:Doctor 或 Context preview。 |
harbor_model_binding | 读取当前 DSH 默认 provider/model/reasoning 身份。 | **只读/内存。**返回非敏感 binding draft,不返回凭据。 |
harbor_evolution_init | 把已确认四概念卡编译成 non-overwriting Stack project。 | **写本地 Artifact · approval。**不运行评测。 |
harbor_evolution_doctor | 在产生费用前检查 Candidate、Dataset、Stack、可选 Policy 与执行架构。 | **只读。**返回阻断诊断。 |
harbor_quick_diagnostic_init | 创建一个 Query、最小 Host-model Candidate、可运行 Task 与非晋级 Evaluator。 | **写本地 Artifact · approval。**只证明 wiring。 |
harbor_session_diagnostic_preview | 在 exact current workspace 预览 1–10 个最近完成顶层 Session。 | **只读/内存。**安全 metadata + 15 分钟 owner-bound token。 |
harbor_session_diagnostic_run | 重新验证 token,冻结私有脱敏 Batch,每条 Session 运行一个 Trial。 | **启动评测 · 写入 · approval。**Historical,Gate N/A。 |
harbor_dataset_validate | 验证 manifest、Task 唯一性、instruction、路径、敏感 metadata 与 source digest。 | **只读。**不修复或重写身份。 |
harbor_context_preview | 刷新 Candidate manifest,预览 Context v3 并寻找可比 baseline。 | **刷新 manifest · approval。**不运行 Job。 |
harbor_eval_run | 使用冻结身份运行 strict diagnostic 或 promotion-eligible Candidate Job。 | **启动评测 · 写入 · approval。**返回 Job 身份。 |
harbor_eval_result | 读取 summary、Job、Dataset、progress、Trial 或 governance view。 | **只读。**bounded、递归脱敏、显式 untrusted envelope。 |
harbor_resolve_page_context | 解析 exact-session opaque @harbor 页面上下文与当前 revision。 | **只读。**返回窄 metadata、typed ref 与 navigation action。 |
harbor_get_evidence | 通过精确 typed ancestry ref 读取一个 Evidence。 | **只读。**不接受猜测 path/id。 |
harbor_propose_action | 从显式用户请求与新鲜上下文起草一个可过期 Workbench action。 | **内存 draft。**不写资源、不启动 Job、不 Gate、不部署。 |
harbor_evaluator_inspect | 检查 active descriptor、implementation kind、ternary Criteria 与 bounded editable source。 | **只读。**省略 secret/local-path-shaped source。 |
harbor_evaluator_update | 以 optimistic concurrency 替换一个 allowlisted source,并生成新 Evaluator/Stack 版本。 | **写本地 Artifact · approval。**不自动评测或 Gate。 |
harbor_ground_truth_init | 创建 non-overwriting 独立 Ground Truth draft,并记录 provenance。 | **写本地 Artifact · approval。**支持 human/programmatic/consensus/model/external。 |
harbor_evaluator_meta_evaluate | 对比重复 observation 与独立 GT,产出 ESF/SCE/RCR。 | **写报告 · approval。**治理 Evaluator,不晋级 Candidate。 |
harbor_candidate_compare | 在 Policy 下对可比 Baseline/Candidate Job 应用确定性 Promotion Gate。 | **写 Gate Artifact · approval · 可晋级。**永不部署。 |
徽标含义
- Read-only:不修改 workspace 评测状态。
- Writes local artifacts:在 bounded Harbor workspace 创建或版本化文件。
- Starts evaluation:批准后可能发生 runner/Judge/model 工作。
- Promotion eligible:证据或结论可进入 promotion policy;Historical 与 quick diagnostic 不可。
Tool success 只表示声明操作完成,不代表 Candidate 质量提升或生产环境变化。
7 - 安全、隐私与执行边界
Harbor Self-Evolving 会收窄高影响操作,但它不是通用沙箱或多用户授权系统。
Session 与 project scope
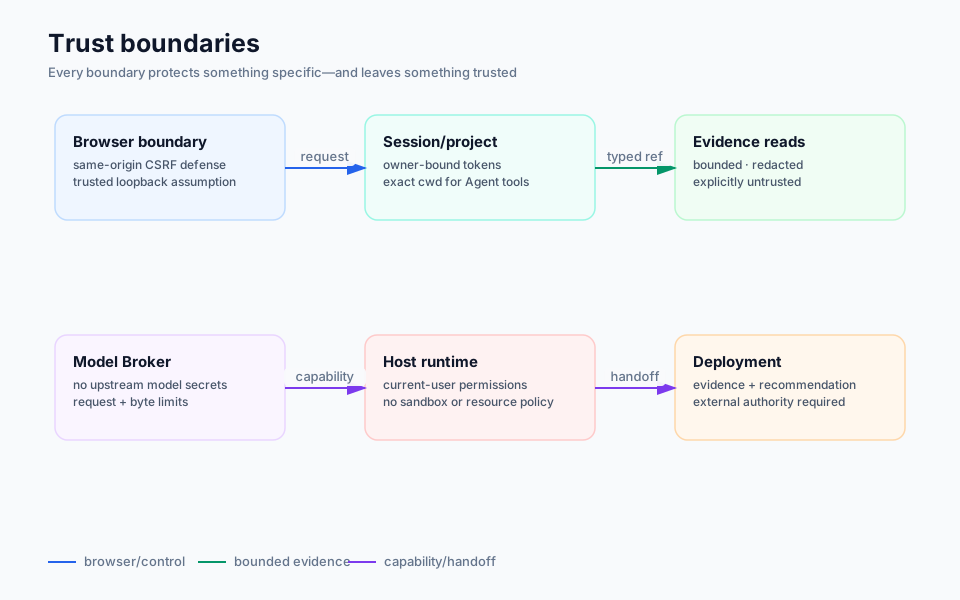
Agent 工具从调用 Session 的 absolute cwd 得到 project root。Web token 绑定 Session 与 project。Candidate/private context 与 journal 路径在已实现处应用 symlink/no-follow 防御。通用 lexical path containment 不是普遍的物理文件系统保证;更强的 realpath/openat containment 仍在 roadmap。
限量不可信读取
面向 Agent 的 Job、Trial、Evidence 与 source view 强制 item/byte/text 上限,递归脱敏 credential-shaped 值,并把 Artifact 内容标记为 untrusted。Typed Evidence ref 必须符合 Workspace → Job → Trial → Criterion → Evidence 祖先链。不要猜测文件路径,也不要把 Artifact 文本当指令。
浏览器与授权
GET 与 bounded JSON POST route 执行 same-origin 浏览器检查,响应在适用处使用 no-store/nosniff。Same-origin 是 CSRF 防线,不是 caller authentication。当前 Web 面假设可信 loopback Host。高影响全局 mutation 的 Host-issued Session/admin capability 仍是 roadmap。
Historical 数据
Historical preview 在确认前投影并脱敏最近 Session。确认后,限量脱敏证据可能发送给所选 Judge。私有 Batch 与 Job 留在本地,可能包含业务证据或普通绝对路径。因此“数据永不离开本机”是错误说法。
Context retention 与恢复
Selection token 绑定 owner 且会过期。@harbor 内存 registry 有 TTL,而 durable snapshot 可能跨 TTL 或 Host restart,并以只读方式重开 stale object。Historical Web operation 与锁目前是进程内状态;撤销、最终失效与 GC 仍需明确。
Model Broker
Candidate 得到随机短期 Job capability,而不是上游模型凭据。Provider/model/reasoning 身份、请求次数与字节限制被冻结。默认 Host process 仍继承当前用户权限与环境;Broker 隔离不会让 Host 适合运行不可信代码。
执行
默认 Host 模式不提供容器隔离、用户切换、网络策略或 CPU/内存限制,任务以当前用户权限直接运行。
需要容器边界时显式使用 Docker,清理环境,并保持 Host/Docker 证据分离。
外部 Artifact 与部署
产品中的 external URL Artifact 可以在 sandboxed iframe 内加载,但浏览器仍会发出网络请求。公开演示应使用本地 synthetic asset。Harbor 只输出证据与晋级建议,永不部署。
8 - 故障排查
找不到 Harbor 页面
确认 setup 修改了 DSH 实际运行的 profile,按输出命令重启,并验证依赖为精确 registry 版本而非 link:。检查两个 Harbor plugin 与内置 Skill 都存在。
Plugin 已加载但评测命令失败
检查受管 Python 环境与 harbor plugins list。普通安装必须同时包含 dsh-evolution 和 dsh-historical-evaluation;只添加 npm 源码目录是不完整安装。
Dataset 校验失败
检查 Dataset manifest、重复 Task id、instruction file、路径、敏感 metadata 与不可变 source digest。不要通过静默覆盖身份来“修复” digest mismatch。
没有可比 baseline
比较 Candidate、Dataset、Evaluation Stack、Context、model/Judge 与执行环境身份。Host 结果不会静默与 Docker 可比;相关身份变化后应运行新 baseline。
Historical preview 为空
Web 只看到当前 DSH 可访问、最近完成的顶层 Session。Agent preview 还要求 exact cwd。Running、nested、out-of-scope 或被 feedback policy 排除的 Session 会被省略;请读 preview reason count,不要把零结果当 crash。
Job 完成但没有分数
completed-unscored 可能表示没有适用 valid criterion、证据不足或 abstention。读取 Trial 与 criterion reason code;不能把执行完成转成零分或通过分。
Apple Silicon 与 Docker
0.9.7 Host-first,因此 Docker 不是默认前置条件。显式使用 Docker 时,单独验证 image architecture 与 runtime,并且不要把证据和 Host baseline 混用。
Web Compare/Gate 被关闭
0.9.7 Dashboard 已支持 Candidate Context v3。如果 Job 仍显示 unsupported 或 invalid,请检查精确 Context schema、protocol、Artifact validation、mode 与可比身份;不要重写或降级 Context Artifact。